
پایگاههای داده بهطور سنتی برای یکی از دو کار ساخته شدهاند. پایگاههای داده تحلیلی به کسبوکارها کمک میکنند تا روندها را شناسایی کنند و به سوالات پاسخ دهند، در حالی که پایگاههای داده عملیاتی سوابق روزمره تراکنشها، مانند سفارشات و پرداختها را ذخیره میکنند. اما موتور پایگاه داده مستقر در مونیخ CedarDB از هر دو پشتیبانی میکند و رویکرد آن با افزایش هوش مصنوعی عاملی مرتبطتر شده است، مریتز سیچرت، هم بنیانگذار و مدیرعامل این شرکت به TechCrunch گفت.
CedarDB در طول یک دهه گذشته در حال ساخت بوده است، اما حرکت کنونی آن ناشی از شرکتهای بزرگ است که ممکن است ذخیره سالها تراکنش را بهخوبی انجام داده باشند، اما کمتر قادر به پاسخگویی سریع به سوالات تحلیلی از طریق زبان طبیعی درباره آن دادهها باشند.
سوالات CedarDB درباره تقسیم بین پرسشهای تحلیلی و عملیاتی محصولی از تمرکز آن بر کارایی است. این شرکت یک اسپینآف از دانشگاه فنی مونیخ است که بر اساس Umbra، یک پروژه تحقیقاتی که از صفر ساخته شده تا موتورهای پایگاه داده قدیمی را در سرعت پردازش شکست دهد، بنا شده است.
با پنج محقق از Umbra بهعنوان هم بنیانگذاران، CedarDB این رویکرد را حفظ کرد و وعده عملکرد سریعتر را بدون نیاز به افزایش سرورها یا قدرت پردازش و حافظه — و با نیاز به تغییرات کم از طرف مشتریان — داد. بهویژه، تیم آن اطمینان حاصل کرد که CedarDB با PostgreSQL، یک سیستم پایگاه داده متن باز سازگار است.
بر اساس گفتههای سیچرت، این سازگاری با پایگاه داده محبوب کمک میکند تا هزینههای انتقال پایین نگه داشته شوند، زیرا کاربران نیازی به بازسازی برنامههایشان ندارند. همچنین یک مزیت اضافی دارد: CedarDB بر اساس منطقی که LLMها عمدتاً با آن آشنا هستند، عمل میکند.
این تصمیم یکی از بسیاری از انتخابهایی بود که در retrospect خوششانس به نظر میرسد، سیچرت گفت. اما همهچیز خوششانس نبود. در یک نوشته وبلاگی، هم بنیانگذار کریستین وینتر اولویتهای کلیدی را که تیم پس از ترک دنیای دانشگاهی مشخص کرد، تشریح کرد: “مانند قابلیت اطمینان، تحمل خطا و سازگاری با ابزارهای محبوب.”
همه پاسخها واضح نبودند. تیم به شدت در مورد این که آیا باید فوراً یک پیشنهاد ابری راهاندازی کند، بحث کرد. در نهایت، CedarDB Enterprise را بهعنوان یک پیشنهاد داخلی در کنار نسخه رایگان آن، CedarDB Community Edition، راهاندازی کرد، هر دو در ماه می سال گذشته اعلام شدند، همزمان با اعلام یک دور تأمین مالی بذر به مبلغ 5.3 میلیون یورو (تقریباً 6 میلیون دلار).
پیشنهاد ابری تنها به تعویق افتاد، نه abandon شده است. پس از انجام آزمایشهای بتا با کاربرانی که برای فهرست انتظار آن ثبتنام کرده بودند، این شرکت روز چهارشنبه در TechCrunch Disrupt از عرضه محدود CedarDB Cloud خبر داد، جایی که با 20 استارتاپ دیگر رقابت میکند تا در رقابت معتبر Startup Battlefield competition برنده شود.
نسخه کاملاً مدیریت شده و مستقر در ابر احتمالاً به CedarDB کمک میکند تا پایگاه کاربری خود را فراتر از شرکتهای بزرگ گسترش دهد. همچنین این شرکت را بهتر آماده میکند تا با شرکتهایی مانند Databricks، یک شرکت بزرگ داده که به نظر میرسد به همان نتیجه CedarDB رسیده است، رقابت کند.
در نشست Data + AI خود در ماه ژوئن، این شرکت آمریکایی “عصر عاملی” را بهعنوان دلیلی برای راهاندازی LTAP، یک معماری داده جدید که به “[یکپارچگی] تراکنشها، تجزیه و تحلیلها، استریمینگ و دادههای عملیاتی در یک نسخه ذخیرهسازی مشترک در دریاچه.” اشاره کرد.
هنوز زود است که بگوییم این چقدر میتواند شگفتانگیز باشد، اما سیچرت حرکت Databricks را بهعنوان یک نشانه دیگر تعبیر میکند که تقاضا برای آنچه CedarDB انجام میدهد وجود دارد. این استارتاپ قصد دارد کاربران اول خود را با تیم کنونی 14 نفرهاش خدمترسانی کند؛ اما سیچرت انتظار دارد که پس از اینکه توجه بیشتری جذب کرد به یک تیم بزرگتر نیاز داشته باشد. “و اینجاست که ما دور بعدی را جمعآوری خواهیم کرد.”
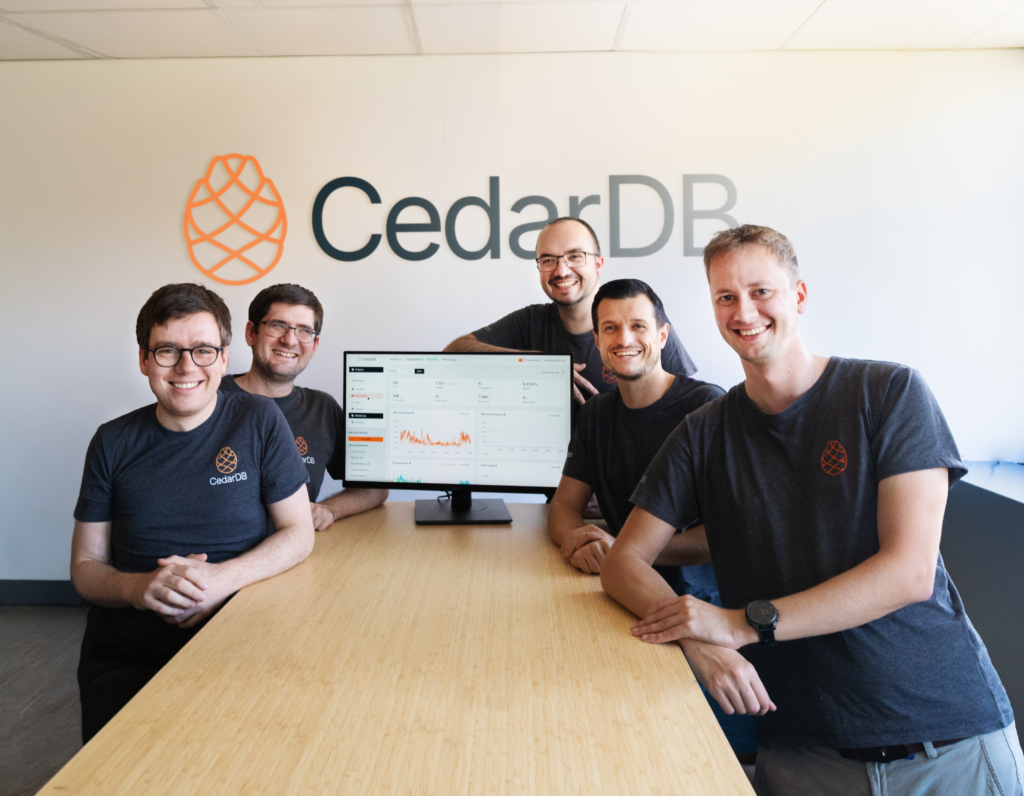
از چپ به راست: بنیانگذاران CedarDB مریتز سیچرت، لوکاس واگنر، فیلیپ فنت، دومینیک دورنر و کریستین وینتر.