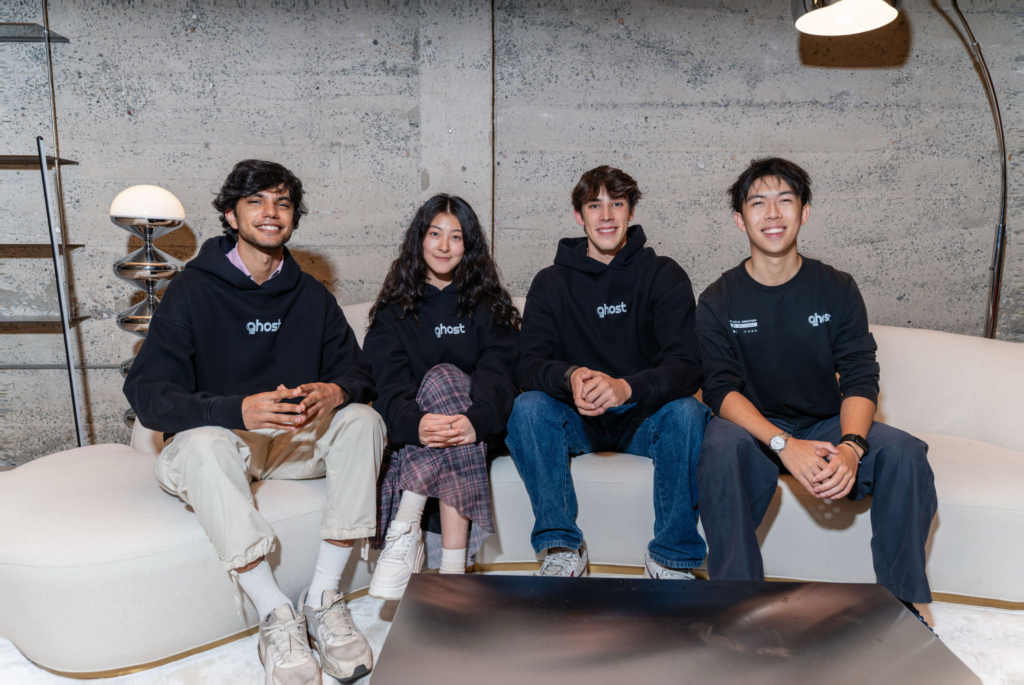

الوریان، استارتاپ هوش مصنوعی واقع در پالو آلتو که ۵۵ میلیون دلار در دور اولیه جمعآوری سرمایه با ارزش ۳۰۰ میلیون دلار قبل از راهاندازی محصول خود جذب کرده است، روز جمعه نخستین مدل خود را ارائه کرد، بهطور انحصاری توسط TechCrunch گزارش شده است.
این مدل، Glimpse نام دارد و بهعنوان یک پیشنمايش تحقیقاتی با دسترسی به API و یک رابط چت که تنها در لیست انتظار است، راهاندازی میشود. بنابراین در حال حاضر، این تنها یک جدول نتایج و یک پایاننامه است. پایاننامه چیست؟ مدلهای هوش مصنوعی امروز، با تمام تواناییهایشان در زبان و کد، هنوز واقعاً نمیتوانند ببینند.
بیشتر مدلهای چندرسانهای یک بار تصویر را مشاهده کرده، آن را به توکنها تبدیل میکنند و سپس درباره آن در متن استدلال میکنند — مانند توصیف یک عکس از حافظه. Glimpse مدام به منبع بازمیگردد. در میانه استدلال، میتواند به یک ناحیه برش بزند، فریمهای خاصی از یک ویدیو را استخراج کند یا کدی را برای اندازهگیری یا مقایسه آنچه که مشاهده میکند، اجرا کند، مکانیسمی که الوریان آن را «فضای یادداشت بصری» مینامد. تصور کنید که کسی برای تأیید آنچه که فکر میکرده میبیند، به یک عکس در گوشی خود زوم میکند.
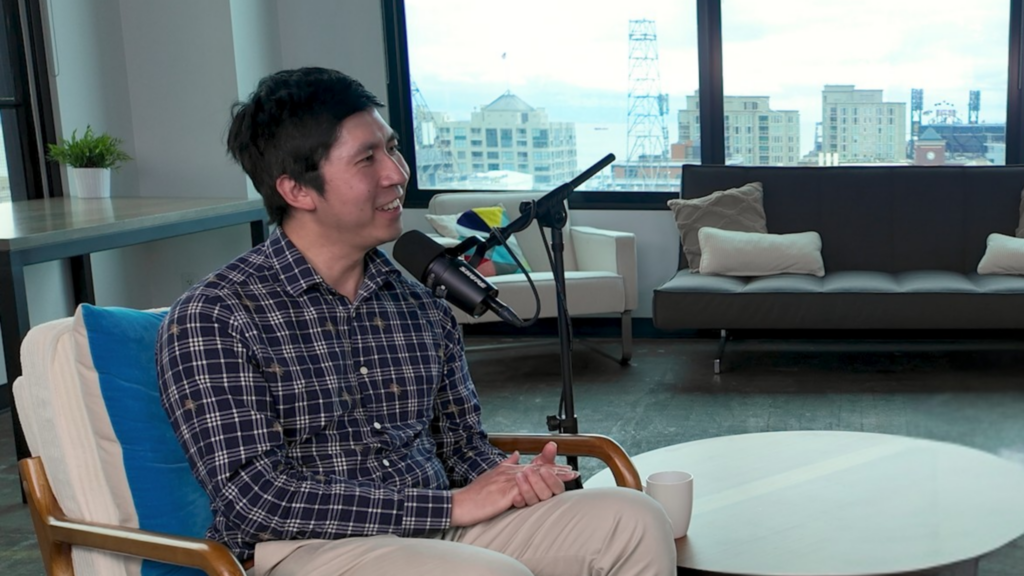
برای اندرو دای، مدیرعامل الوریان و پژوهشگر پیشین گوگل دیپ مایند، یکی از وضوحهای بارز این که هوش مصنوعی هنوز واقعاً نمیتواند ببیند در شب بازی قمست است.
سال گذشته او از یک بازی تختهای که بهتازگی با دوستانش به پایان رسانده بود، عکس گرفت و از یک مدل پیشرفته پرسید که کدامیک در حال برنده شدن است. آن مدل نتوانست بگوید. بازیهای تختهای «هرکدام زبان بصری خاص خود را دارند، هرکدام نمادها و نشانههای خاص خود را دارند»، او به TechCrunch گفت. «برای یک بزرگسال، با حداقل متن، درک آنچه که در حال اتفاق است نسبتاً آسان است، اما این مدلها نمیتوانند بفهمند آن نمادها چه معنایی دارند.»
«انسانها میتوانند به نمودارهای IKEA نگاه کنند، بدون متن، و مبلمان IKEA را مونتاژ کنند، درست است؟ چرا مدلهای هوش مصنوعی نمیتوانند؟» او گفت.
این رویکرد کاملاً جدید نیست — OpenAI در سال ۲۰۲۵ برش و زوم را در حین استدلال به مدلهای سری o خود اضافه کرد — اما تبلیغ الوریان این است که این مدل را بهطور کامل در اطراف آن ساخته است، و بهطور اقتصادی. شرکت میگوید که یک تیم کوچک، Glimpse را بر روی چند صد GPU آموزش داده و اینکه مدل به طور قابل توجهی کوچکتر از سیستمهای پیشرفتهای است که در آن مرجع قرار گرفته است.
Glimpse هزینهای معادل ۰.۶۰ دلار به ازای هر میلیون توکن ورودی و ۳ دلار به ازای هر میلیون توکن خروجی دارد – ارزانتر از مدلهای میانهای مانند Sonnet و Sol اما گرانتر از مدلهای سبک مانند Haiku و Luna.
اما بر اساس ارزیابیهای الوریان، Glimpse حتی از GPT-6 Astra در استدلال نموداری علمی و نوشتن توضیحات برای ویدیوهای کوتاه بهتر عمل میکند و نتایج رقابتی در سایر وظایف استدلال بصری دارد.
الوریان شش ماه پیش از حالت پنهان خود خارج شد با یک دور جمعآوری سرمایه که توسط Striker Venture Partners، Menlo Ventures و Altimeter Capital رهبری میشد، با مشارکت Nvidia و دانشمند ارشد گوگل، جف دین.
هدفهای اولیه شرکتها هستند که بر روی ویدیوهای زیادی نشستهاند: شرکتهای رباتیک، آزمایشگاههای علمی، شرکتهای رسانهای و خلاق. در بلندمدت، الوریان میخواهد از دیدن به انجام دادن منتقل شود. این به معنای ساخت مدلی از یک صحنه است که از آن برای انتخاب یک عمل استفاده میشود، از جمله کنترل مستقیم رباتها. سال آینده، دای گفت که شرکت قصد دارد «بهترین مدل استدلال بصری در جهان» را بسازد، مدلی که در هر آزمون استدلال بصری رهبری کند.